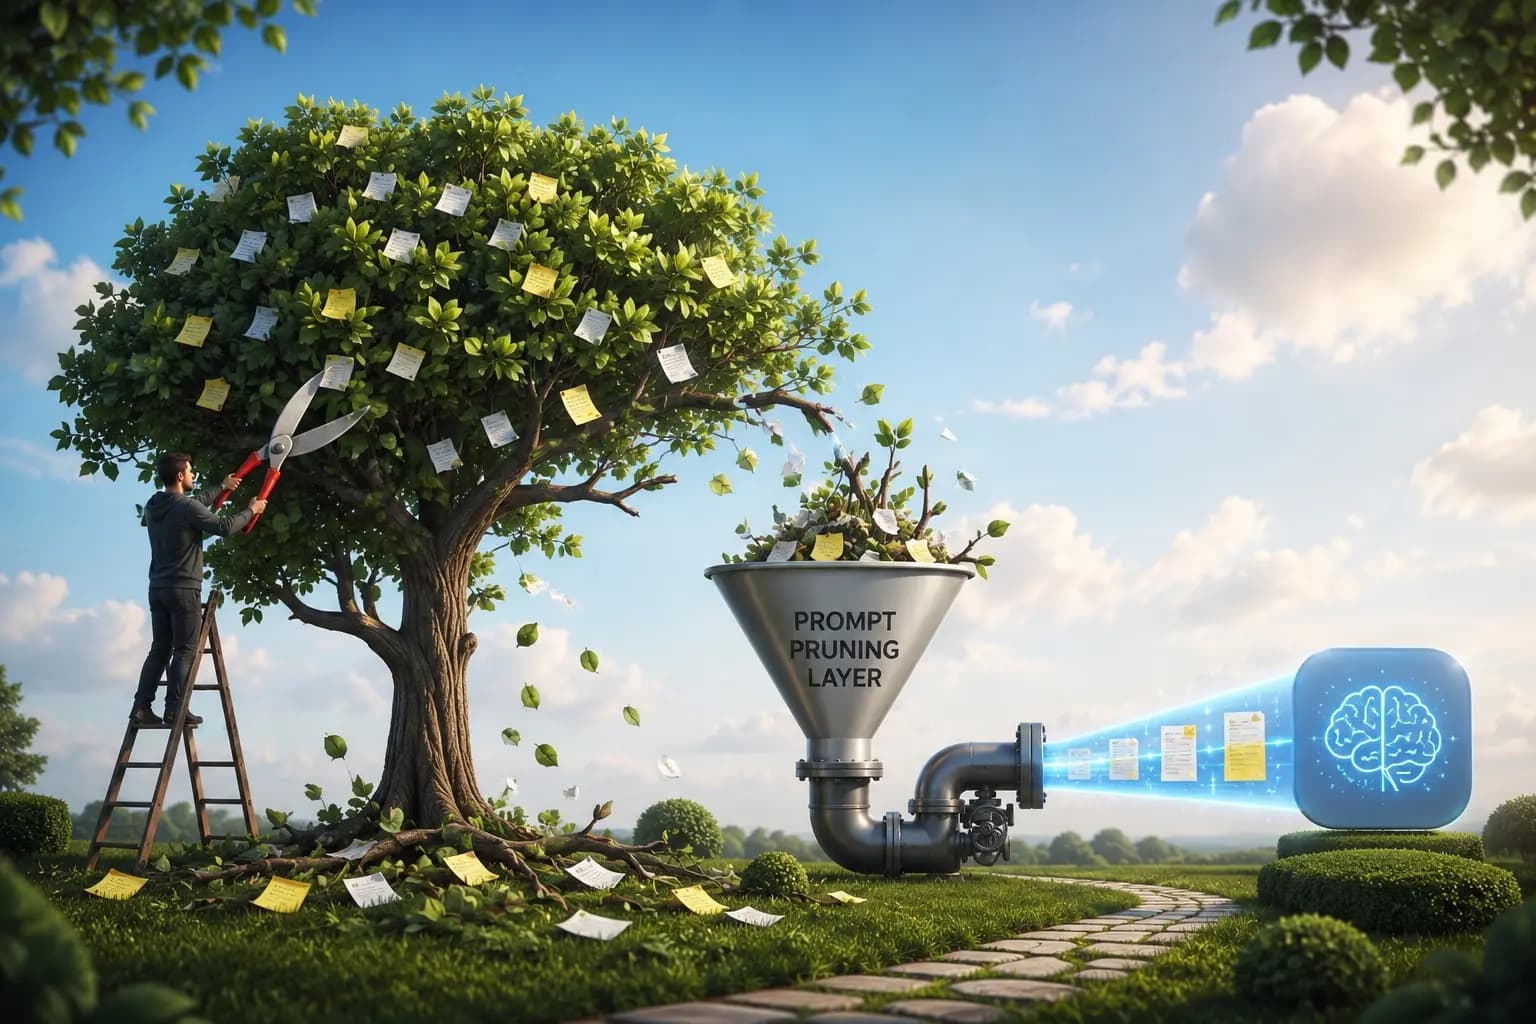
Nueva capa de poda de prompts mejora eficiencia en modelos LLM
Emmimal P Alexander desarrolló una capa de poda determinista que reduce tokens redundantes en prompts de modelos de lenguaje, optimizando costos y rendimiento.
Emmimal P Alexander creó una capa de poda segura para prompts en sistemas de modelos de lenguaje grandes (LLM), que elimina contexto redundante antes de procesar la entrada, reduciendo costos y latencia sin perder información clave.
Por qué importa: Esta innovación permite manejar conversaciones extensas en LLM sin que el tamaño del prompt afecte negativamente el rendimiento ni la precisión del modelo.
Lo esencial
La capa realiza tres pasos: eliminación de contexto expirado, eliminación de duplicados y restauración de dependencias.
Reduce tokens entre 2-4% en chat simple y hasta 34% en agentes con múltiples herramientas.
El procesamiento se mantiene rápido, con menos de 50 ms incluso en conversaciones de 2,000 turnos y 131,000 tokens.
Imagen de referencia: Towards Data Science.
Reducción determinista de contexto redundante
El sistema diseñado por Alexander evita llamadas a modelos LLM, embeddings o dependencias externas, usando solo componentes estándar para garantizar decisiones reproducibles y deterministas. Esto asegura que la poda no elimine información necesaria para la coherencia de la conversación.
El proceso se divide en tres fases: primero, elimina contexto expirado que ya no aporta valor; luego, elimina duplicados que inflan el prompt; finalmente, restaura dependencias para que ningún mensaje necesario sea eliminado accidentalmente.
Impacto en costos y rendimiento de LLM
Al reducir el tamaño del prompt, se disminuyen los costos de inferencia y la latencia, factores críticos en aplicaciones que manejan diálogos largos o agentes con múltiples herramientas. La reducción varía según la carga de trabajo, siendo más significativa en sistemas que integran recuperación de información (RAG) y agentes con herramientas complejas.
Además, la poda mantiene la integridad del contexto, evitando degradación en el razonamiento del modelo, un problema común cuando se manejan prompts muy extensos.
Pruebas y validación exhaustiva
El método fue probado en 15 configuraciones distintas, combinando tres tipos de cargas de trabajo y cinco tamaños de conversación en dos máquinas diferentes. En todos los casos, se preservaron los hechos requeridos y el sistema alcanzó un punto fijo estable tras una sola pasada, lo que significa que podar un prompt ya podado no genera cambios adicionales.
El código completo y las pruebas están disponibles públicamente, facilitando su adopción y evaluación por la comunidad.
Preguntas frecuentes sobre la capa de poda de prompts
¿Qué garantiza que no se elimine información importante?
La fase de restauración de dependencias asegura que ningún mensaje del que dependa otro sea eliminado, manteniendo la coherencia y relevancia del contexto.
¿Es compatible con cualquier modelo LLM?
Al ser una capa previa al modelo que solo usa componentes estándar y no depende de embeddings ni llamadas externas, puede integrarse con distintos sistemas LLM sin afectar su funcionamiento.