Gemma 4 E4B: modelo LLM compacto que funciona en Raspberry Pi y GPUs potentes
Gemma 4 E4B es un modelo de lenguaje grande (LLM) que combina tamaño reducido con capacidad para tareas complejas, funcionando en dispositivos como Raspberry Pi y GPUs avanzadas.
Gemma 4 E4B es un modelo de lenguaje grande (LLM) que destaca por su tamaño compacto y su capacidad para ejecutar cargas de trabajo típicas de LLM en dispositivos con recursos limitados, como una Raspberry Pi, así como en estaciones de trabajo con GPUs potentes.
Por qué importa: Este modelo permite desplegar inteligencia artificial avanzada en hardware modesto sin sacrificar precisión, ampliando las posibilidades de uso local y eficiente.
Lo esencial
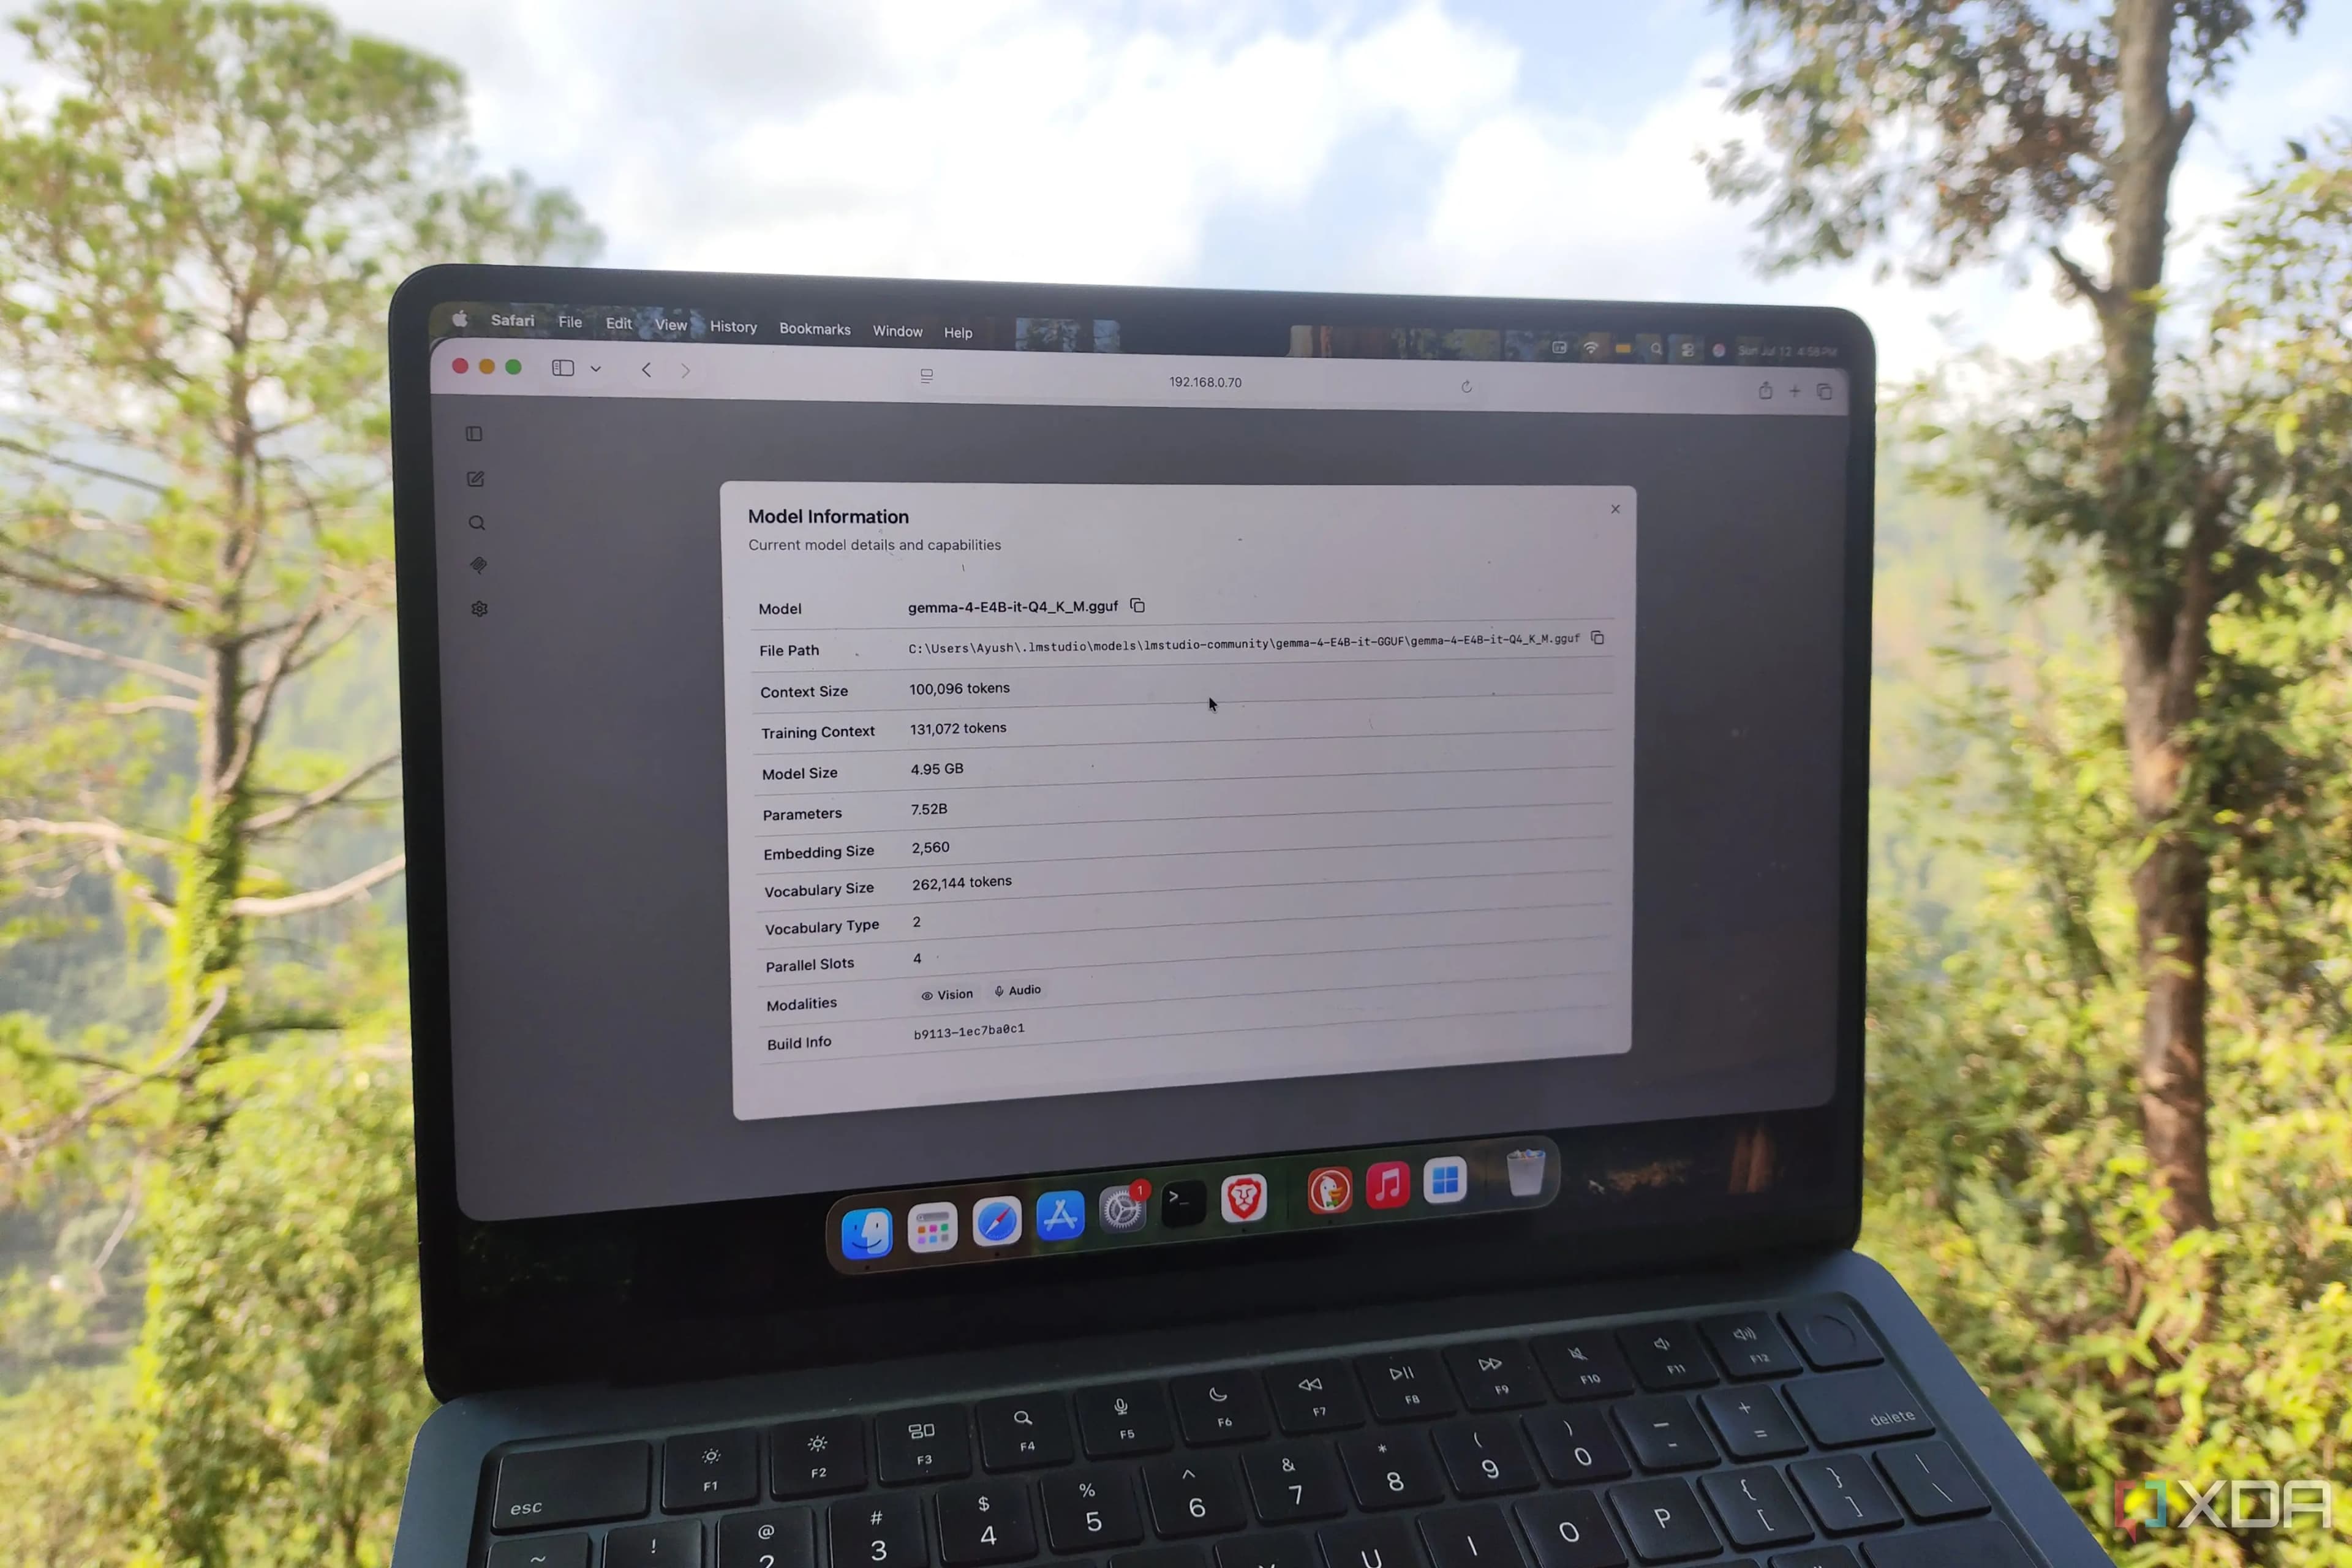
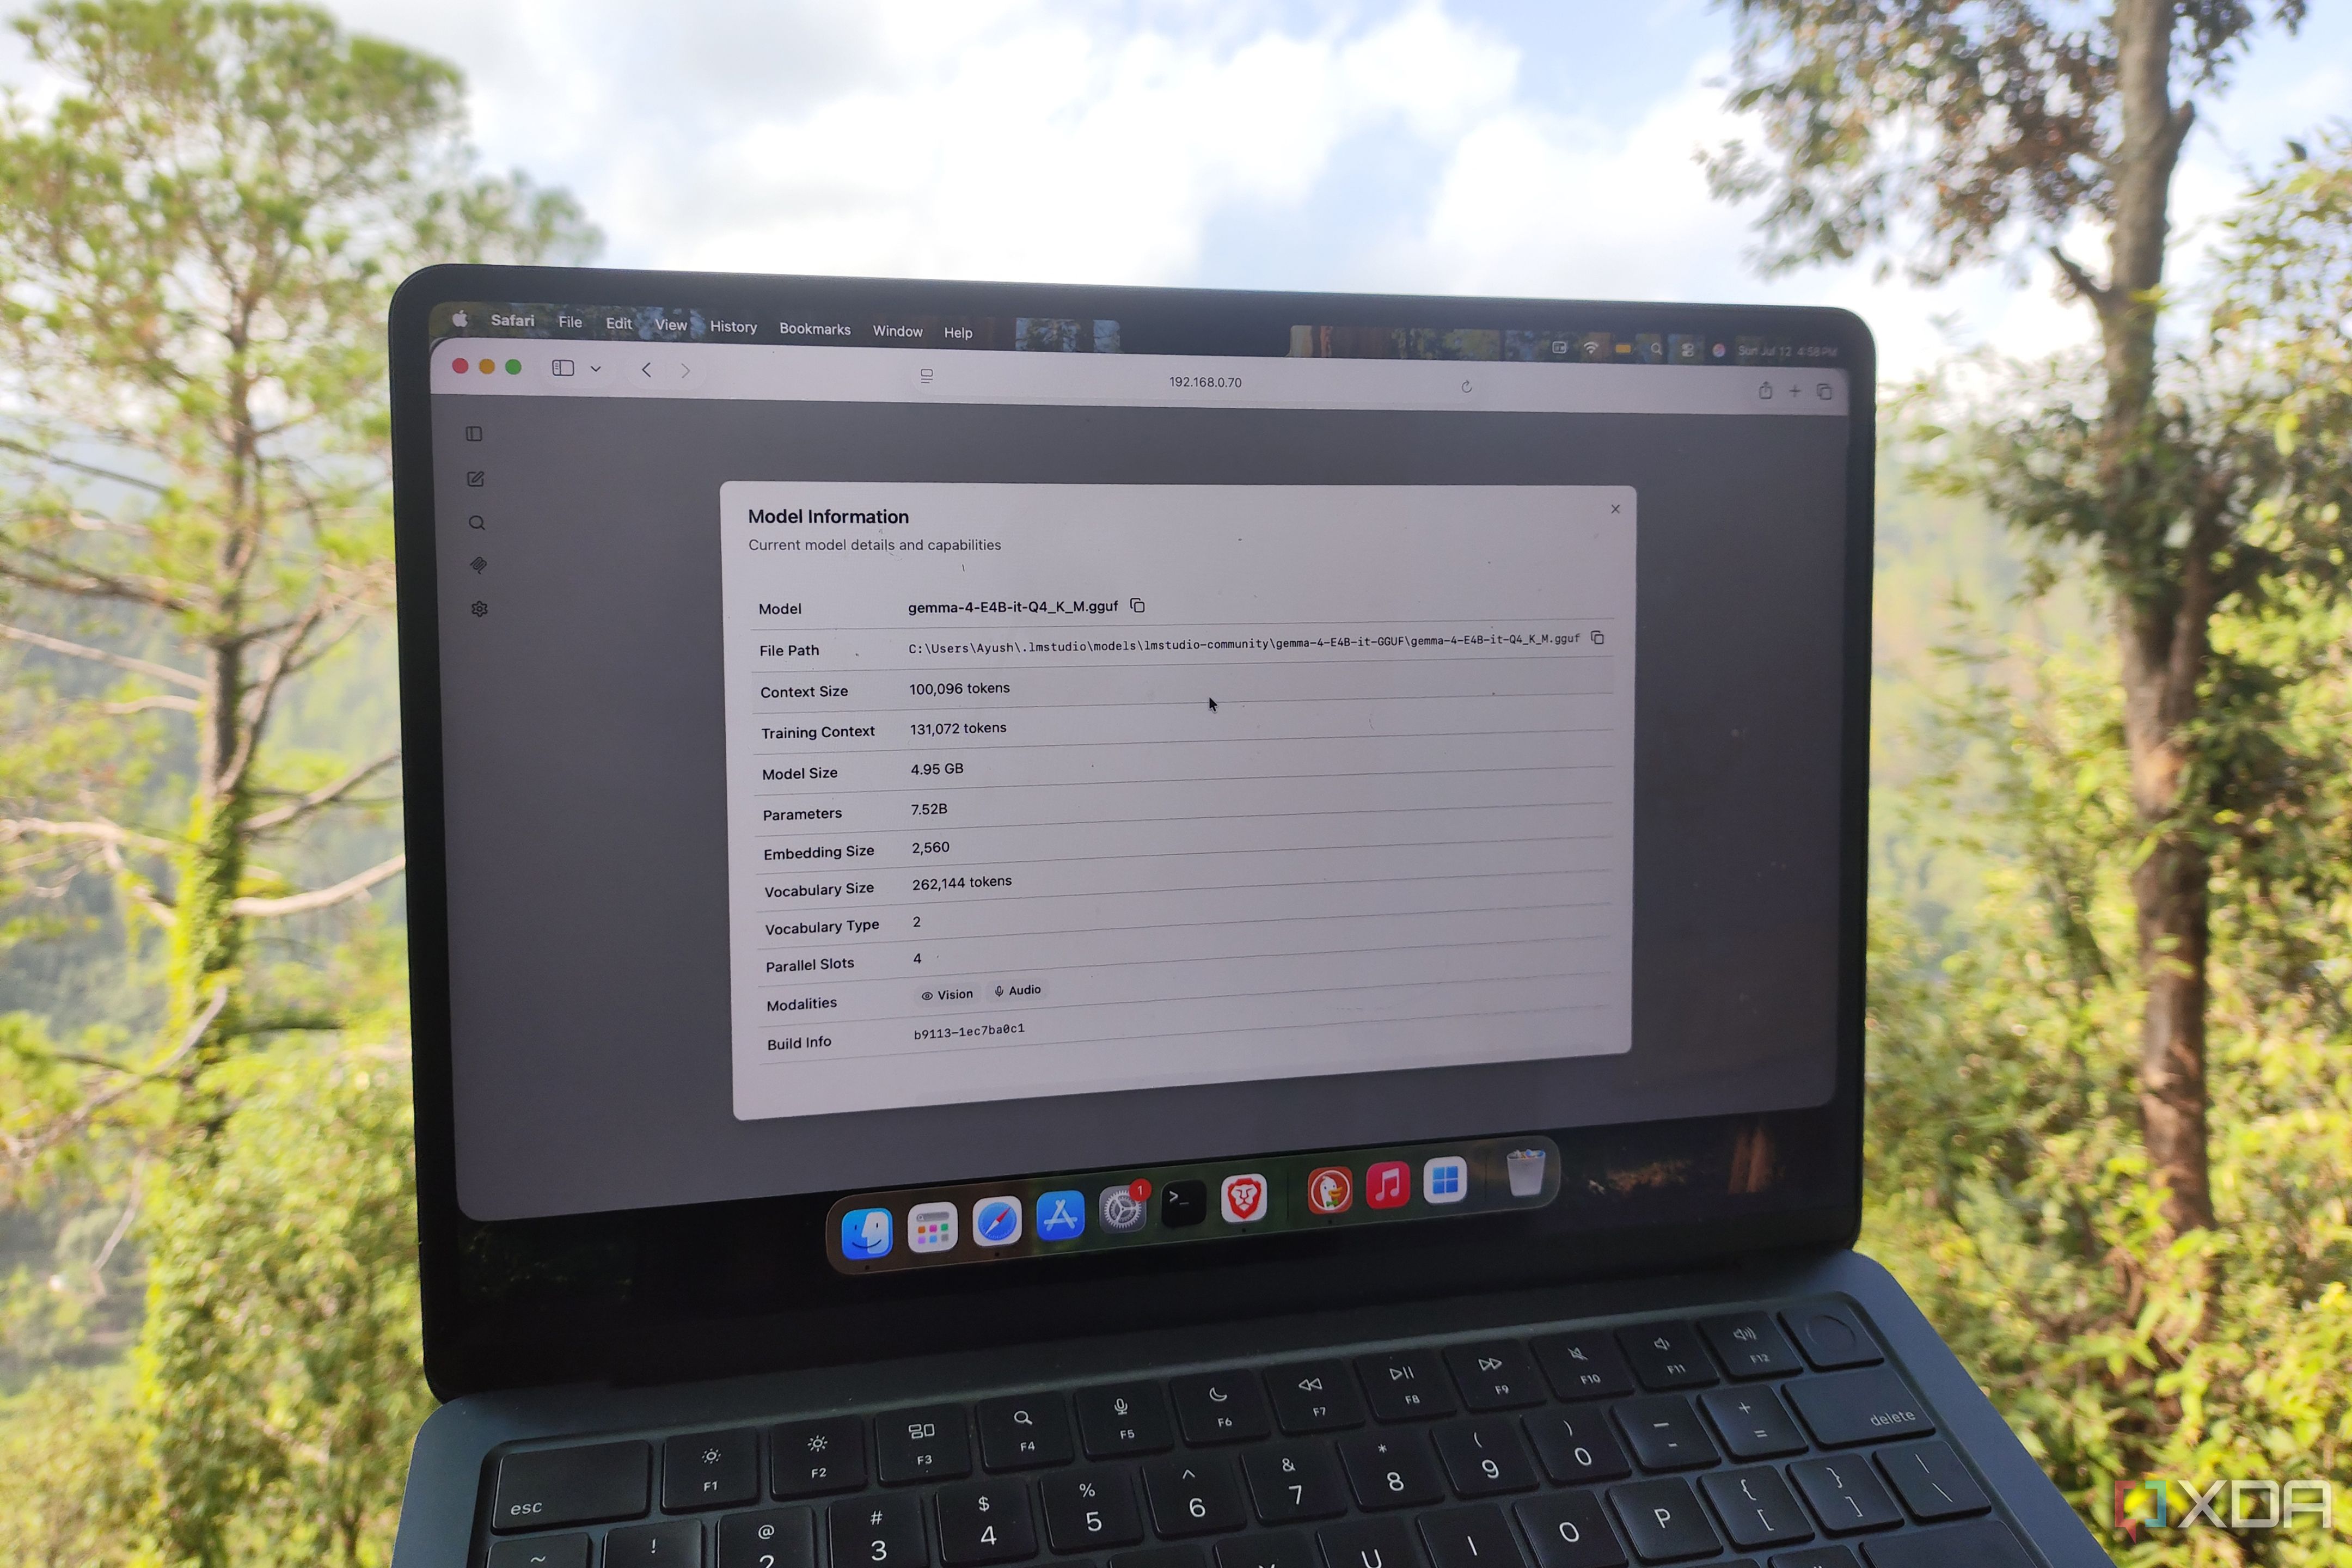
Gemma 4 E4B utiliza una arquitectura de Per-Layer Embeddings que reduce sus parámetros efectivos a 4.5 mil millones.
Funciona en sistemas de bajo rendimiento como Raspberry Pi 5 con 8GB de RAM, generando entre 2.95 y 3.25 tokens por segundo.
En GPUs como GTX 1080 y RTX 3080 Ti, alcanza velocidades de hasta 40 y casi 120 tokens por segundo respectivamente.
Imagen de referencia: XDA Developers.
Arquitectura innovadora para eficiencia y precisión
Gemma 4 E4B implementa Per-Layer Embeddings (PLE), que asigna una tabla de embeddings a cada capa decodificadora. Esto permite al modelo acceder a más información sin aumentar excesivamente el uso de recursos, manteniendo un tamaño efectivo reducido pero con capacidad de razonamiento comparable a modelos de 8 mil millones de parámetros.
Rendimiento en hardware modesto
El modelo ha sido probado en una Raspberry Pi 5 con 8GB de RAM, un dispositivo que normalmente no soporta modelos de 6 mil millones de parámetros. A pesar de la limitada potencia, Gemma 4 E4B responde con resultados sólidos, superando a otros modelos más pequeños que presentan problemas de precisión y estabilidad.
Velocidad y capacidades en GPUs avanzadas
En estaciones de trabajo equipadas con GPUs como la GTX 1080 y la RTX 3080 Ti, Gemma 4 E4B ofrece un rendimiento significativamente mejor, alcanzando velocidades de generación de tokens de hasta 40 y casi 120 tokens por segundo respectivamente. Además, el modelo soporta procesamiento de audio y visión, ampliando su utilidad en aplicaciones multimedia.
Aplicaciones prácticas y compatibilidad
Durante las pruebas, Gemma 4 E4B fue capaz de modificar y utilizar extensiones de software existentes para responder consultas complejas, demostrando flexibilidad y robustez en entornos reales. Esto la convierte en una opción viable para desarrolladores y entusiastas que buscan desplegar IA local sin necesidad de hardware costoso.
Preguntas frecuentes sobre Gemma 4 E4B
¿Qué es Per-Layer Embeddings y cómo mejora el modelo?
Es una técnica que asigna una tabla de embeddings a cada capa del decodificador, permitiendo mayor acceso a información sin aumentar el tamaño del modelo, mejorando eficiencia y precisión.
¿En qué dispositivos puede funcionar Gemma 4 E4B?
Puede ejecutarse en dispositivos de bajo rendimiento como Raspberry Pi 5 con 8GB de RAM, así como en estaciones de trabajo con GPUs potentes como GTX 1080 y RTX 3080 Ti.