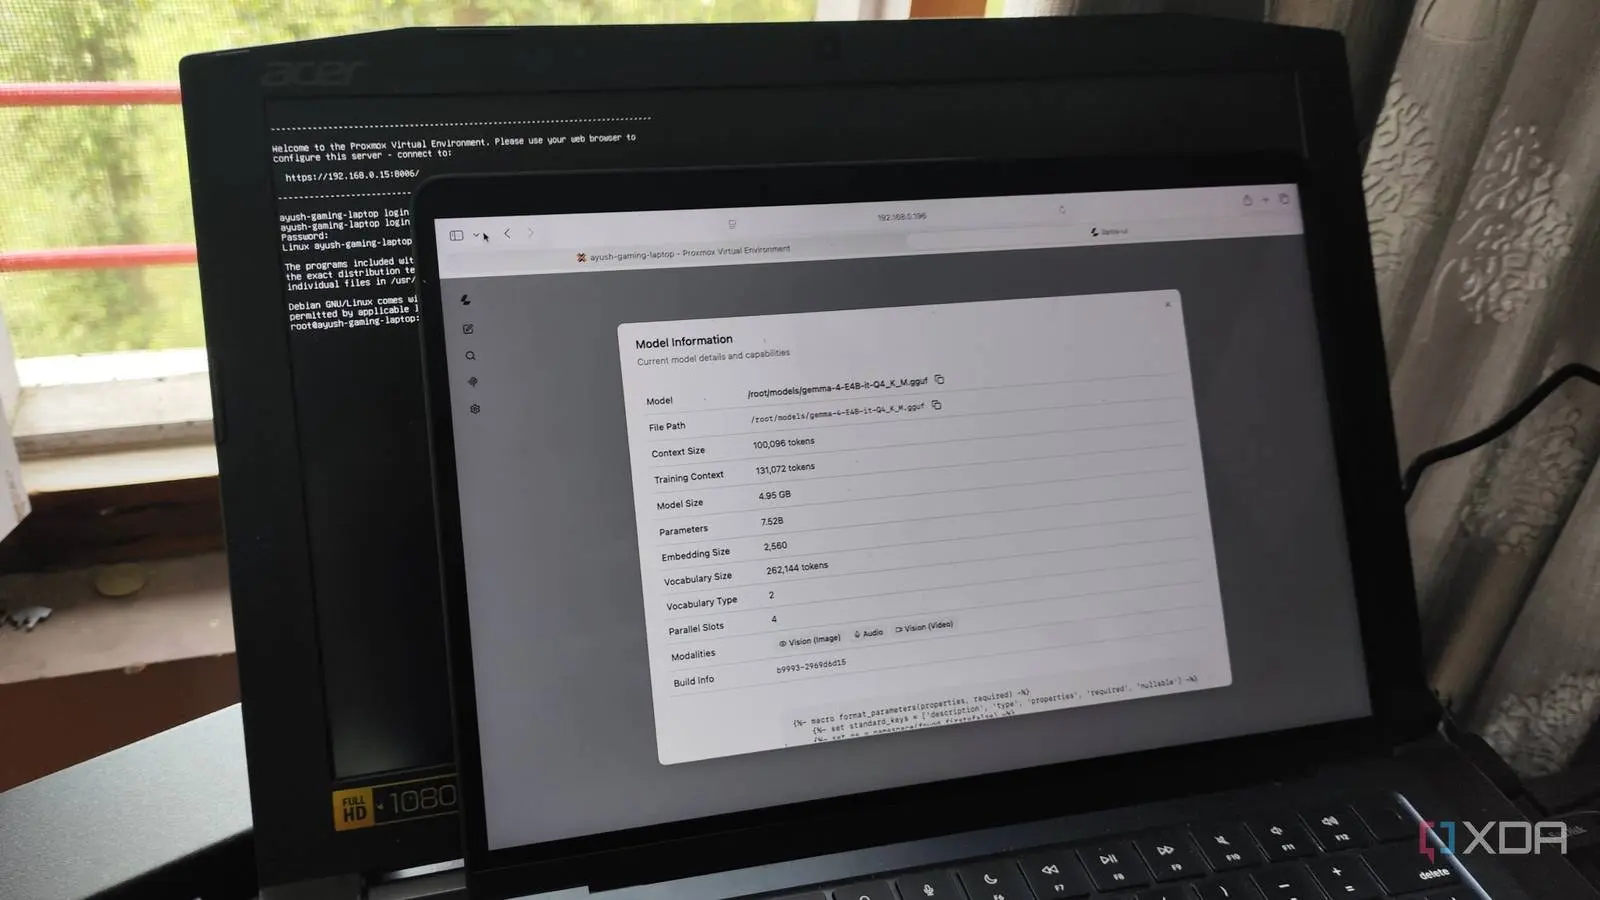
Ayush Pande, escritor especializado en hardware y juegos, logró reemplazar el uso de ChatGPT con un modelo de lenguaje grande (LLM) local ejecutado en una laptop antigua Acer Predator Helios 300 de 2017. Esta iniciativa permite mejorar la privacidad al evitar el envío de datos a la nube y reutilizar hardware obsoleto para tareas de inteligencia artificial.
Por qué importa: Ejecutar modelos de IA localmente en equipos antiguos reduce la dependencia de servicios en la nube y protege la privacidad del usuario.
Lo esencial
El modelo local llama.cpp se ejecuta en una laptop con GPU GTX 1060 y 16 GB de RAM.
Se utilizó Proxmox como sistema operativo para gestionar contenedores y aislar el entorno de IA.
Se aplicaron configuraciones específicas para compatibilizar drivers Nvidia antiguos con el modelo y la GPU Pascal.
Imagen de referencia: XDA Developers.
Optimización de hardware antiguo para IA local
El autor aprovechó su laptop gamer de 2017, equipada con una GPU Nvidia GTX 1060 y 16 GB de RAM DDR4, para alojar un modelo de lenguaje local llamado llama.cpp. A pesar de ser hardware de una generación pasada, con ajustes y optimizaciones, el equipo puede manejar cargas de trabajo de modelos de lenguaje grandes para tareas de productividad.
Uso de Proxmox para gestión y aislamiento
Para administrar el entorno local, se eligió Proxmox, una plataforma de virtualización que permite ejecutar contenedores LXC con aislamiento y gestión avanzada. Esto facilita reemplazar aplicaciones en la nube como ChatGPT con soluciones completamente locales, mejorando la seguridad y privacidad.
Configuración de drivers y compatibilidad GPU
Debido a que las últimas versiones de Proxmox y los drivers Nvidia no soportan GPUs Pascal como la GTX 1060, se optó por mantener Proxmox en su versión 9.0 y usar el driver Nvidia 580.119.02. Se configuró el passthrough de GPU al contenedor LXC, incluyendo ajustes en los archivos de configuración y permisos, para que llama.cpp pudiera utilizar la aceleración por GPU.
Compilación y ajustes de llama.cpp
Para que llama.cpp detectara correctamente la GPU y no cayera en procesamiento por CPU, fue necesario compilar una versión basada en Vulkan. Esto permitió aprovechar la GPU Pascal para inferencia, mejorando el rendimiento del modelo local en la laptop antigua.
Preguntas frecuentes sobre llama.cpp y modelos locales
¿Qué es llama.cpp?
Es un proyecto que permite ejecutar modelos de lenguaje grandes localmente, optimizado para hardware modesto y con soporte para aceleración por GPU.
¿Por qué usar un modelo local en lugar de ChatGPT?
Ejecutar un modelo local mejora la privacidad al no enviar datos a la nube y permite reutilizar hardware antiguo para tareas de IA sin depender de servicios externos.