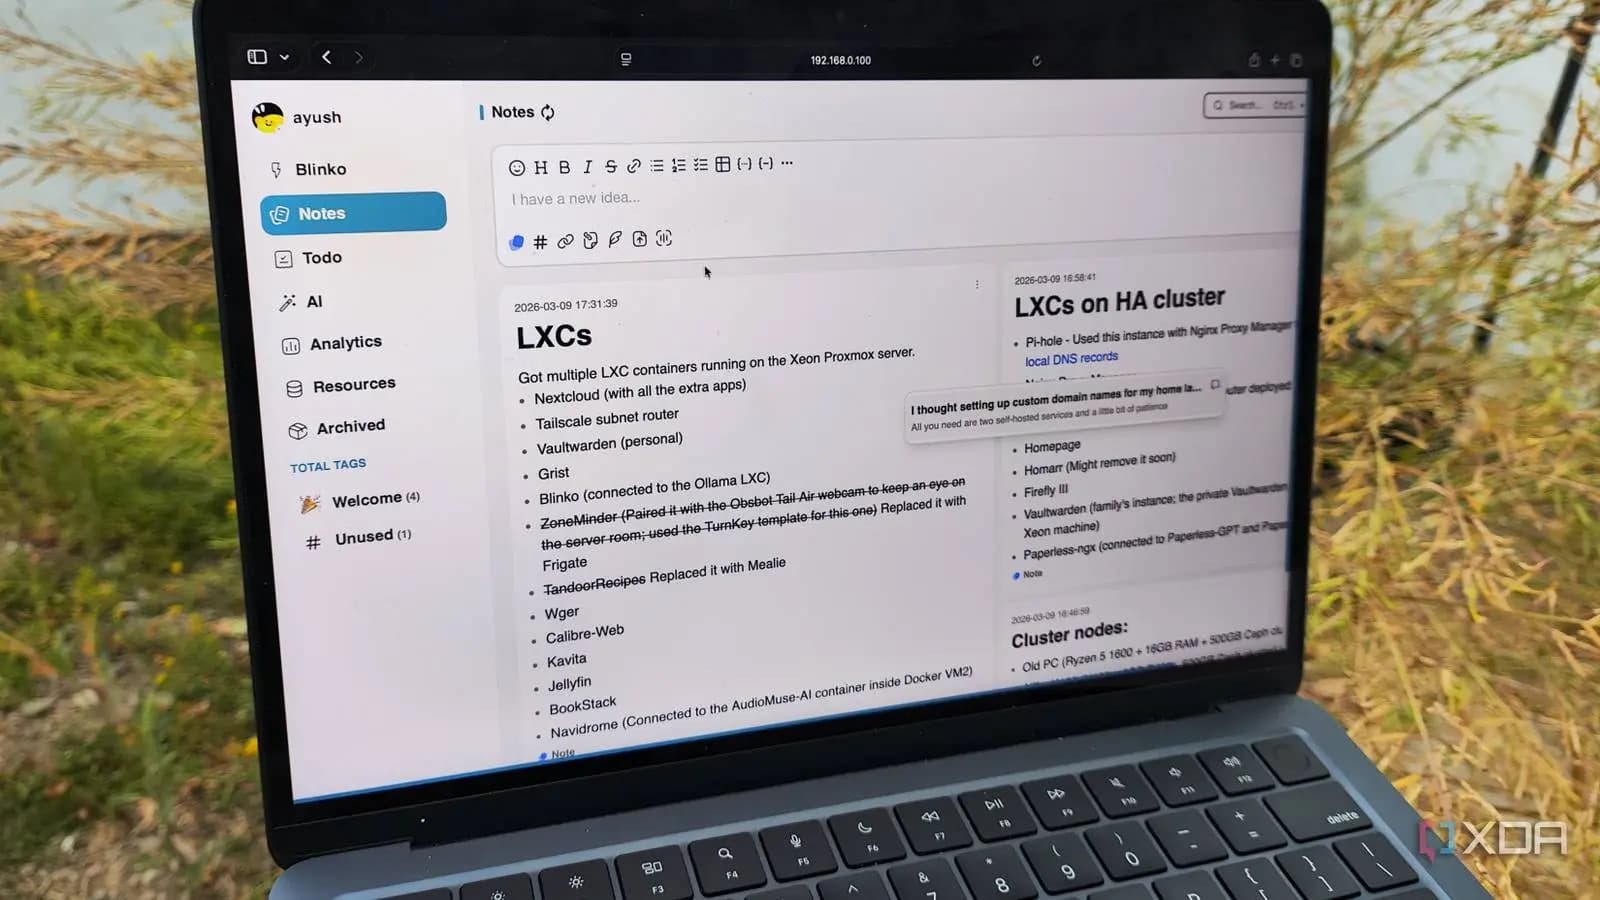
Cada vez más usuarios prefieren modelos de lenguaje locales para gestionar notas con IA, mejorando privacidad y rendimiento sin depender de la nube.
Usuarios de aplicaciones de productividad están migrando de modelos de lenguaje en la nube a modelos locales de lenguaje grande (LLMs) para gestionar sus notas personales, mejorando la privacidad y manteniendo un rendimiento eficiente.
Por qué importa: Esta tendencia muestra cómo la combinación de modelos de lenguaje locales y aplicaciones de código abierto puede ofrecer capacidades avanzadas de IA sin comprometer datos sensibles en la nube.
Lo esencial
Los modelos de lenguaje locales permiten procesar notas sin subir datos a la nube, protegiendo la privacidad.
Los modelos de incrustación (embedding models) facilitan búsquedas contextuales eficientes en colecciones de notas.
Modelos mixtos de expertos (Mixture-of-Experts) optimizan el uso de recursos, permitiendo correr LLMs en GPUs con memoria limitada.
Imagen de referencia: XDA Developers.
Modelos de incrustación para búsquedas contextuales
Los modelos de incrustación convierten notas en vectores que agrupan información similar y separan datos no relacionados. Esto permite que las aplicaciones de toma de notas con IA realicen búsquedas contextuales precisas mediante flujos de trabajo de generación aumentada por recuperación (Retrieval-Augmented Generation, RAG).
Un ejemplo destacado es Nomic Embed Text V1.5, que puede ejecutarse incluso en dispositivos modestos como una Raspberry Pi, facilitando la integración en entornos locales sin necesidad de hardware avanzado.
Modelos mixtos de expertos optimizan recursos
Los modelos Mixture-of-Experts (MoE) distribuyen la carga computacional entre la GPU y la CPU, permitiendo que partes del modelo menos usadas se ejecuten en memoria del sistema, mientras que la GPU maneja las tareas críticas. Esto posibilita correr LLMs grandes en GPUs con VRAM limitada sin perder rendimiento.
Imagen de referencia: XDA Developers.
El autor utiliza modelos como Gemma-4-26B-A4B en una GPU GTX, logrando una velocidad de 15 tokens por segundo, y alterna con GPT-OSS-20B o Qwen3.6-35B para tareas que requieren mayor rapidez.
Ventajas de evitar la nube en gestión de notas
Al mantener los modelos y datos localmente, los usuarios evitan riesgos asociados a la privacidad y dependencia de servicios externos. Esto es especialmente relevante para información sensible o personal, donde la confidencialidad es prioritaria.
Además, la combinación de aplicaciones de código abierto y modelos ligeros permite una experiencia fluida sin necesidad de hardware costoso o conexiones constantes a internet.
Imagen de referencia: XDA Developers.
Preguntas frecuentes sobre modelos locales para notas con IA
¿Qué es un modelo de incrustación y por qué es útil?
Un modelo de incrustación transforma texto en vectores que representan su significado, facilitando búsquedas contextuales y agrupación de información relacionada dentro de grandes colecciones de notas.
¿Qué beneficios ofrecen los modelos Mixture-of-Experts?
Estos modelos optimizan el uso de recursos al distribuir tareas entre GPU y CPU, permitiendo ejecutar LLMs grandes en hardware con memoria limitada sin sacrificar rendimiento.