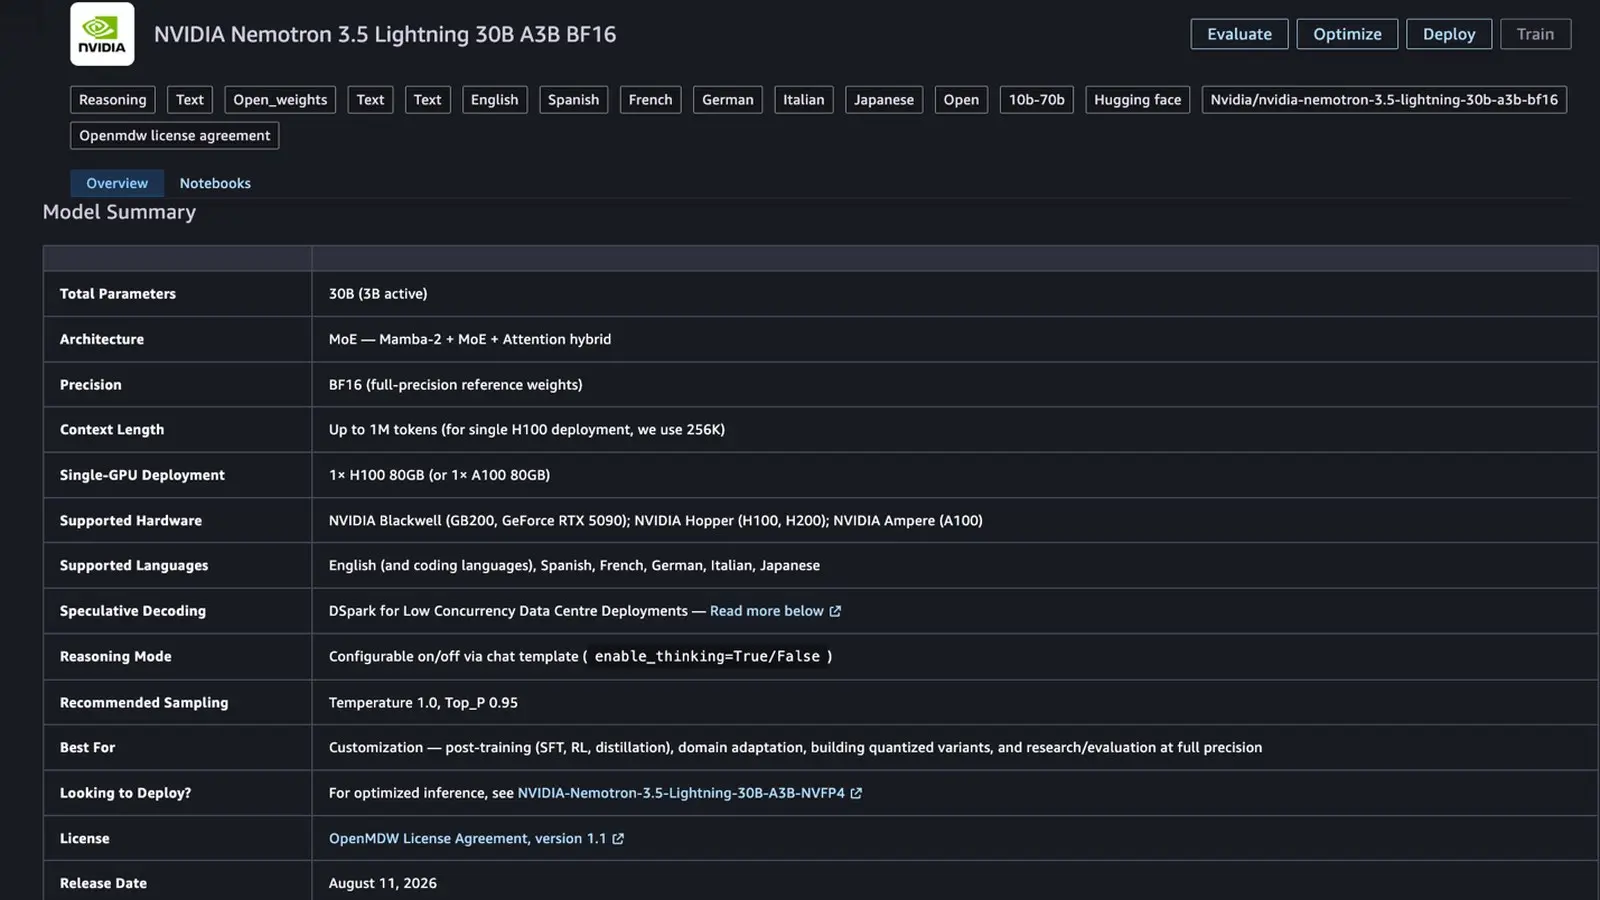
AWS incorporó NVIDIA Nemotron 3.5 Lightning a Amazon SageMaker JumpStart, lo que permite desplegar el modelo abierto sin configurar directamente la infraestructura de servicio. La propuesta apunta a reducir la latencia y el costo operativo de las tareas repetitivas ejecutadas por agentes de inteligencia artificial.
Por qué importa: los flujos con agentes pueden generar un gran volumen de llamadas que no siempre necesitan un modelo de frontera. Nemotron 3.5 Lightning busca cubrir esas operaciones especializadas con menor demanda de infraestructura.
Lo esencial
- El modelo tiene 30.000 millones de parámetros totales, pero activa solo 3.000 millones en cada ejecución.
- NVIDIA afirma que alcanza hasta cuatro veces más rendimiento y completa tareas hasta un 30 % más rápido.
- Su ventana de contexto admite hasta un millón de tokens y puede operar en una sola GPU compatible.
Una arquitectura MoE concentra el trabajo en 3B de parámetros
Nemotron 3.5 Lightning utiliza una arquitectura híbrida de mezcla de expertos, conocida como Mixture-of-Experts (MoE). Aunque el modelo reúne 30B de parámetros, cada pasada activa únicamente 3B, una característica pensada para sostener un rendimiento elevado durante sesiones largas y conversaciones con múltiples turnos.
El sistema también incorpora decodificación especulativa DFlash, que puede disminuir la latencia por token. Según NVIDIA, esta combinación permite obtener hasta cuatro veces más throughput en cargas de agentes de gran volumen, además de reducir hasta un 30 % el tiempo necesario para completar tareas.
Las tareas repetitivas dejan de depender de modelos de frontera
Los agentes permanentes recopilan contexto, observan su entorno, razonan y ejecutan acciones. Algunas fases, como planificar procesos complejos u organizar subagentes, pueden exigir modelos avanzados; otras, como clasificar una alerta, extraer campos de un formulario o validar un registro frente a una política, requieren menos capacidad.
NVIDIA plantea un enfoque compuesto por varios modelos, donde cada paso se dirige a la opción adecuada. Nemotron 3.5 Lightning está diseñado para asumir la parte repetitiva y especializada de ese sistema, evitando aplicar el costo y la latencia de un modelo de frontera a todas las llamadas.