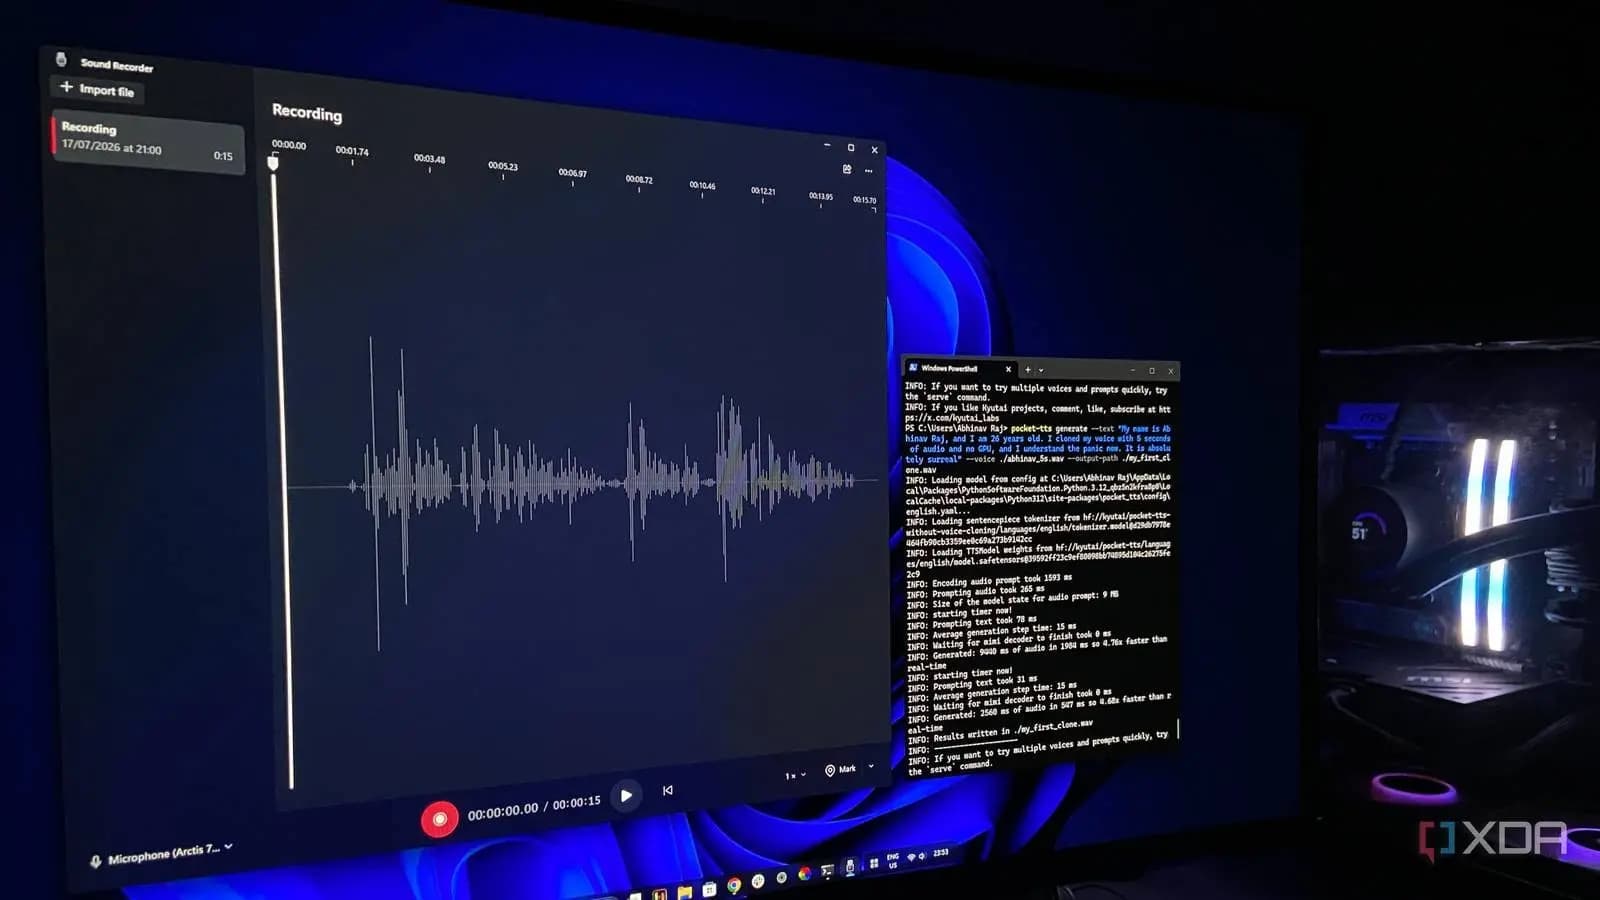
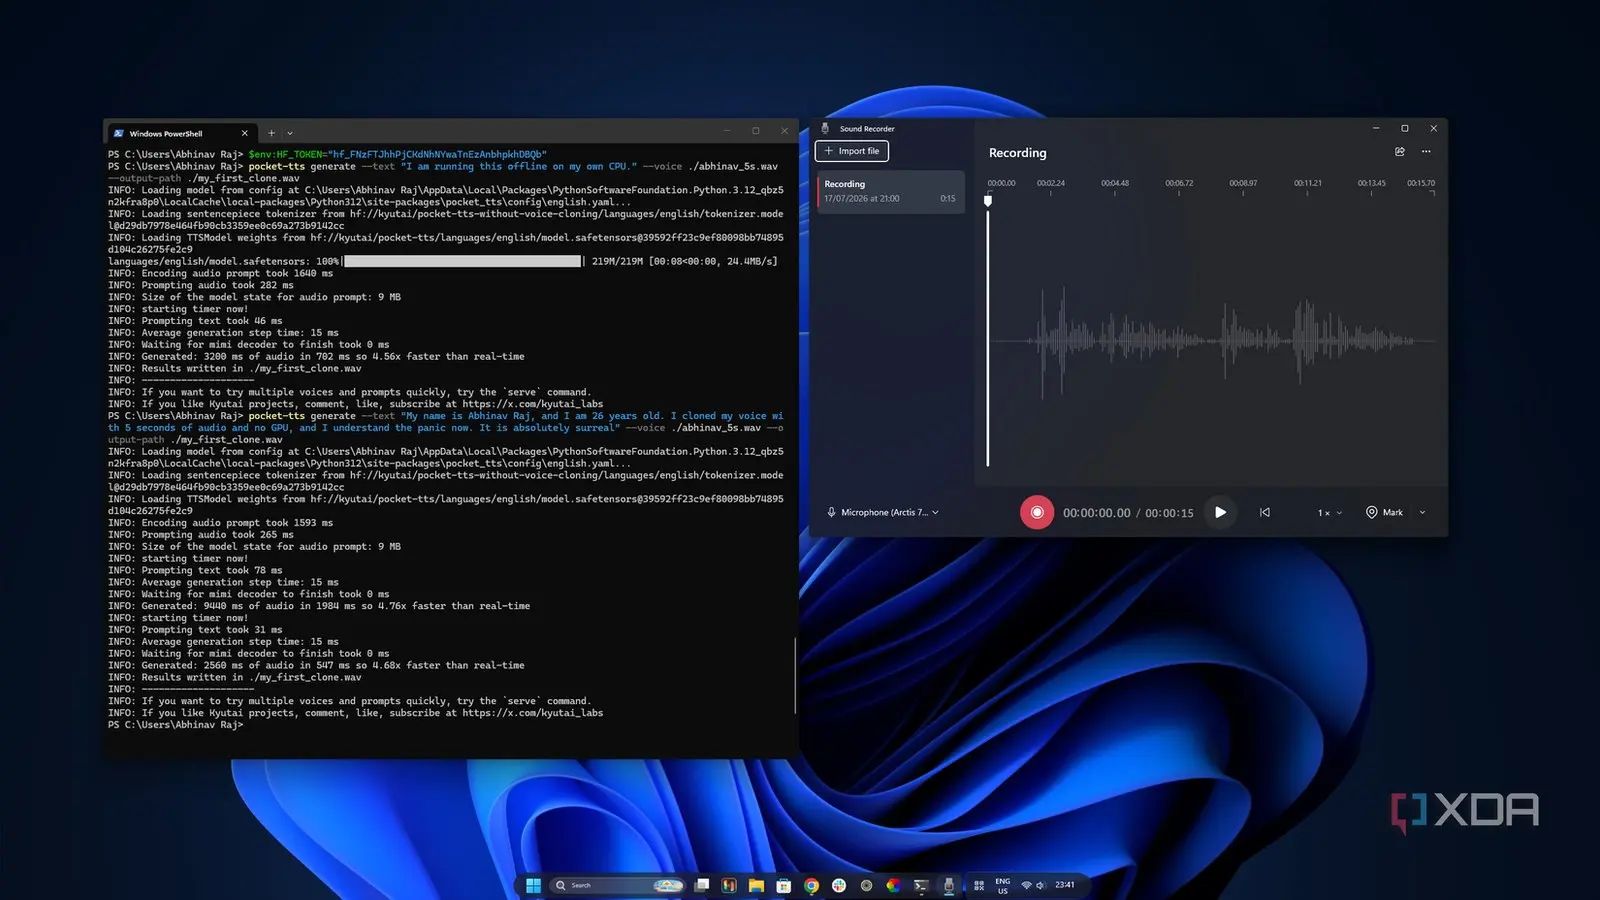
Pocket TTS permite clonar voces con solo 5 segundos de audio y sin necesidad de GPU, lo que facilita la generación rápida y accesible de deepfakes de voz.
Pocket TTS, un modelo de clonación de voz desarrollado por Kyutai, permite replicar voces humanas con apenas cinco segundos de audio y sin requerir una unidad de procesamiento gráfico (GPU), usando solo un procesador Ryzen 5 7600 estándar.
Por qué importa: Esta facilidad para clonar voces con recursos mínimos puede acelerar la proliferación de deepfakes de audio, planteando nuevos retos para la seguridad digital y la detección de fraudes.
Lo esencial
Pocket TTS se instala y ejecuta en menos de 15 minutos sin conocimientos técnicos avanzados.
El modelo pesa aproximadamente 200 MB y se descarga desde Hugging Face.
La generación de audio es casi instantánea, con tiempos de procesamiento inferiores a 50 milisegundos.
Instalación y uso accesible para cualquier usuario
El proceso de instalación de Pocket TTS es sorprendentemente sencillo. No requiere ingeniería inversa ni experiencia en línea de comandos. Con ayuda de un asistente de inteligencia artificial, el usuario puede instalar el paquete, corregir problemas de configuración y ejecutar el modelo siguiendo instrucciones claras. Esto reduce la barrera técnica para crear deepfakes de voz.
Funcionamiento eficiente sin necesidad de GPU
El modelo está optimizado para funcionar en CPUs comunes, como el Ryzen 5 7600, sin aceleración por GPU. Esto se debe a que Pocket TTS es lo suficientemente pequeño y eficiente para que unos pocos núcleos de CPU sean suficientes para la generación rápida de audio. La primera ejecución descarga el modelo, y luego la generación de voz ocurre en milisegundos.
Implicaciones para la seguridad y el fraude digital
La facilidad y rapidez para clonar voces plantea preocupaciones en sectores como la banca y la seguridad. Antes, los deepfakes de audio requerían clips pregrabados y tiempos de generación lentos, lo que daba margen para detectar fraudes. Ahora, con esta tecnología, actores maliciosos podrían generar voces falsas en tiempo real, complicando la autenticación y aumentando el riesgo de estafas.
Imagen de referencia: XDA Developers.
Preguntas frecuentes sobre Pocket TTS
¿Qué cantidad mínima de audio se necesita para clonar una voz?
Solo cinco segundos de audio limpio son suficientes para que Pocket TTS genere una réplica convincente de la voz original.
¿Se requiere hardware especializado para usar Pocket TTS?
No, el modelo está diseñado para funcionar eficientemente en CPUs comunes sin necesidad de GPU, facilitando su uso en computadoras personales estándar.