Saltar al contenido
MENTEDEHACKERS | Cybersecurity | AI | Tech | News

AWS anuncia agente de caché distribuido para reducir costos en LLMs

AWS anuncia agente de caché distribuido para reducir costos en LLMs
LO ÚLTIMO

Los usuarios que autogestionan modelos grandes pueden ahorrar hasta un 40% en costos. El tiempo para la primera palabra se reduce hasta en un 80%.

Los usuarios que autogestionan modelos grandes pueden ahorrar hasta un 40% en costos. El tiempo para la primera palabra se reduce hasta en un 80%. La solución se basa en Amazon ElastiCache.

Por qué importa: Distributed KV caching reduces LLM inference costs and latency significantly
AWS anuncia agente de caché distribuido para reducir costos en LLMs
Imagen de referencia: AWS Machine Learning Blog.

Lo esencial

  • El agente de caché distribuido permite reutilizar estados de atención entre sesiones.
  • Se integra con el Toolkit para AWS y funciona con modelos autogestionados.
  • La solución mejora el rendimiento en agentes de IA y asistentes de documentos.
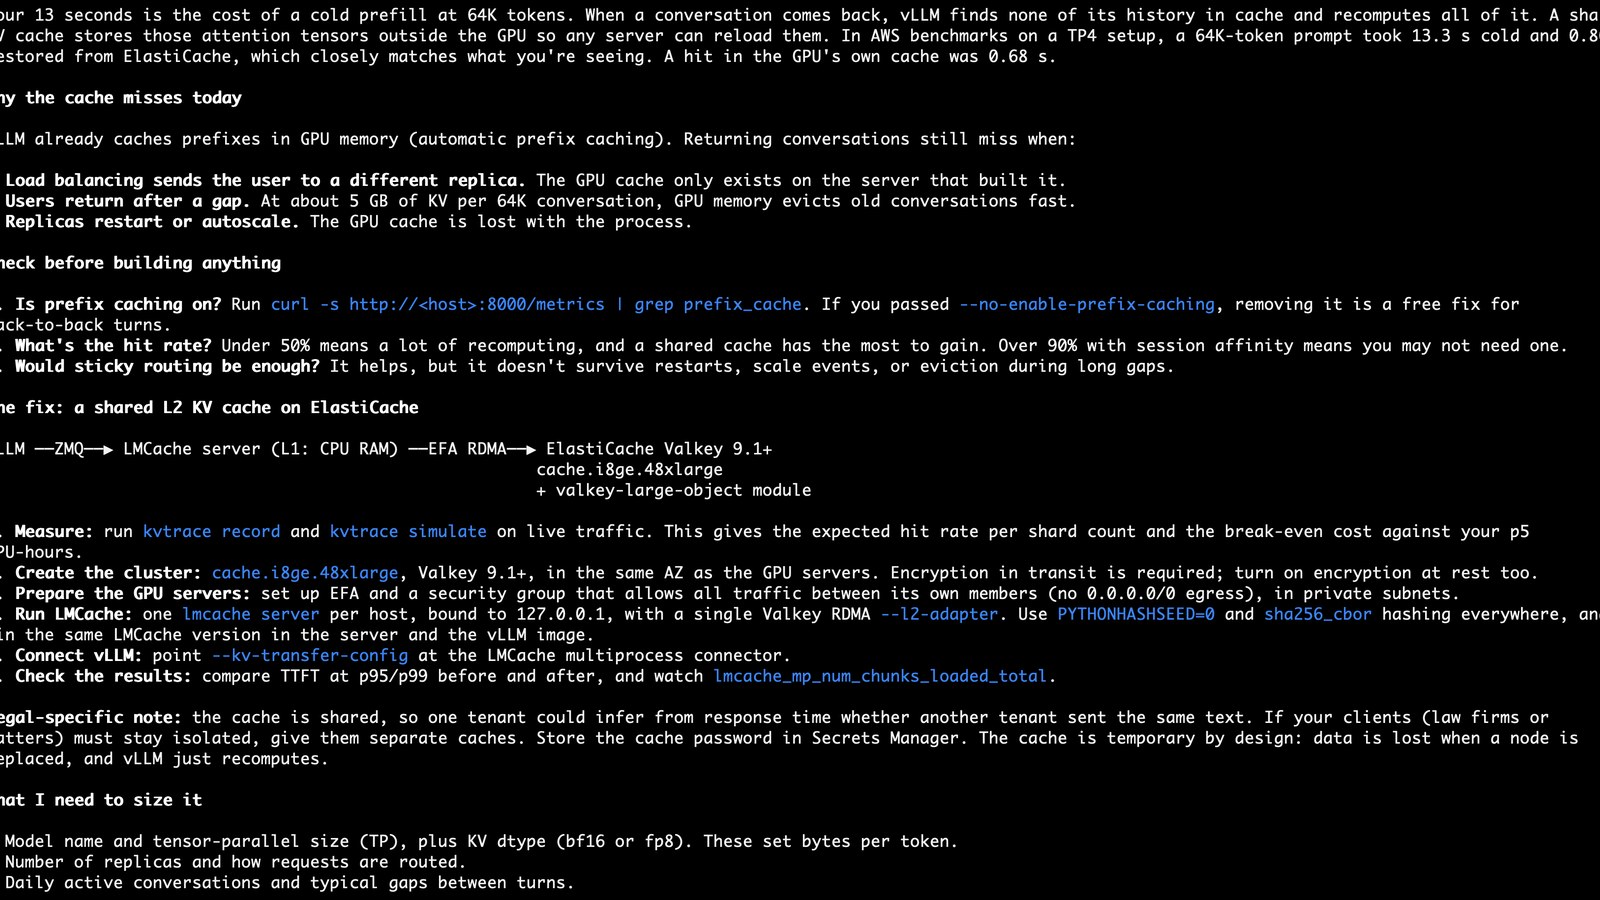
AWS anuncia agente de caché distribuido para reducir costos en LLMs, imagen 2
Imagen de referencia: AWS Machine Learning Blog.

Caché distribuido para LLMs autogestionados

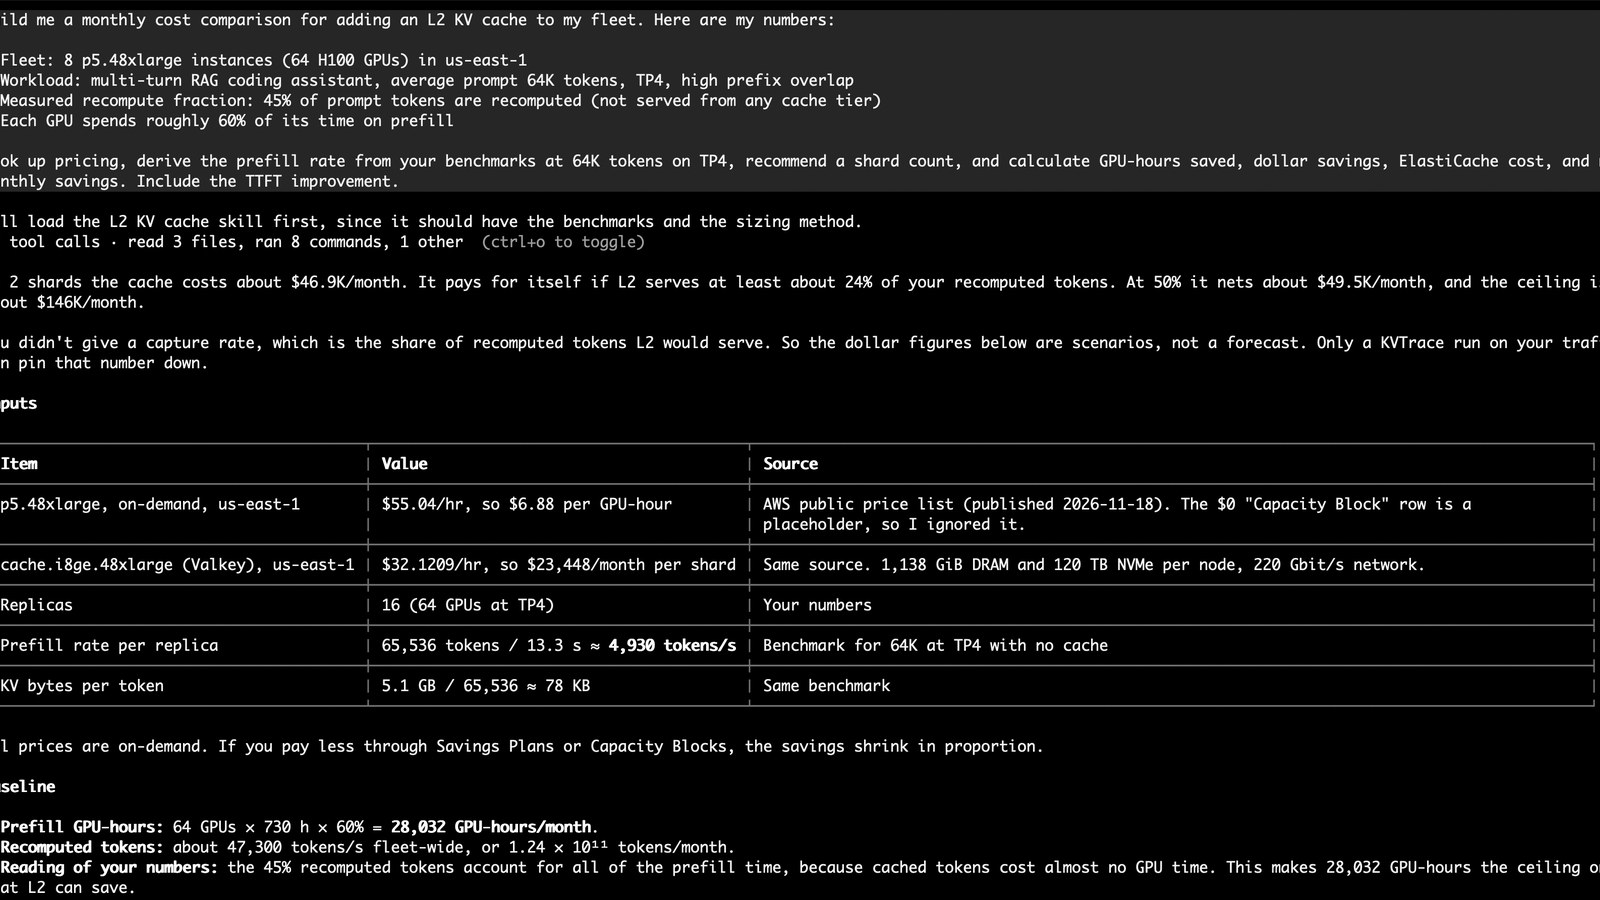
Amazon ElastiCache ofrece un caché distribuido que extiende las memorias locales de GPUs con una capa compartida, permitiendo reutilizar estados de atención entre sesiones.

AWS anuncia agente de caché distribuido para reducir costos en LLMs, imagen 3
Imagen de referencia: AWS Machine Learning Blog.

Mejora en rendimiento y eficiencia

Los resultados muestran un ahorro del 40% en costos y una reducción del 80% en el tiempo para la primera palabra de inferencia.

Fuente original: AWS Machine Learning Blog.

Compartir:

Deja un comentario

Tu correo no se publicará. Los campos obligatorios están marcados *

Artículos relacionados